

Vielleicht erinnern sich einige von euch noch an die Jahrtausendwende. Was würde mit den Computersystemen der Welt passieren, wenn die Jahreszahl von 1999 auf 2000 springt? Dieses technische Problem war real, und Unternehmen sowie Behörden investierten enorme Summen in dessen Behebung. Gleichzeitig entwickelte sich rund um die Jahrtausendwende eine ganz andere Dynamik: Verschiedene Leute prophezeiten den Weltuntergang, von Uriella bis zu den Sekten. Solche Warnungen erzeugen Aufmerksamkeit. Damit stellt sich die interessante Frage: Wo endet berechtigte Risikokommunikation und wo beginnt Dramatisierung?
Wie verhalten sich die Warnungen aus der KI-Forschung und vonseiten der Unternehmen selbst zueinander? Was davon ist plausibel und ab wann beginnt die Spekulation?
In diesem Artikel werden folgende Fragen behandelt:
Wer warnt vor einer Auslöschung durch KI?
Wie realistisch ist ein Kontrollverlust durch KI?
Welche Forschung spricht für ein existenzielles KI-Risiko?
Welche Argumente sprechen dagegen?
Im Jahr 2023 folgten gleich mehrere prominente Warnungen. So forderte das Future of Life Institute am 22. März eine mindestens sechsmonatige Pause beim Training besonders leistungsfähiger KI-Systeme. Zwei Monate später erklärten Hunderte Fachleute und Führungskräfte in einer Stellungnahme des „Center for AI Safety”, das Risiko einer Auslöschung durch KI solle ähnlich ernst genommen werden wie das Risiko von Pandemien oder einem Atomkrieg.
Zu den Unterzeichnern zählten unter anderem Geoffrey Hinton, Yoshua Bengio, Sam Altman von OpenAI, Dario Amodei von Anthropic und Demis Hassabis von Google DeepMind.
Genau in dieser Woche ist die Debatte erneut entfacht. Im September kündigte der 27-jährige Anthropic-Forscher Jacob Coxon seine Stelle. Er hatte drei Jahre lang Pretraining-Forschung bei OpenAI und Anthropic betrieben und warf beiden Firmen vor, unverantwortlich zu handeln und mit unserem Leben zu spielen.
Coxon kennt die Entwicklung grosser Modelle aus der Forschungspraxis. Das bedeutet jedoch nicht, dass seine Zukunftsprognosen automatisch korrekt sind. Seine Aussagen stellen keine wissenschaftlich berechneten Wahrscheinlichkeiten dar, sondern seine persönliche Einschätzung des Risikos.
Was sagt Coxon?
„Keines der beiden Unternehmen handelt verantwortungsvoll.“
„Die Menschen, die KI entwickeln, glauben ernsthaft, dass sie uns alle bis zum Ende dieses Jahrzehnts auslöschen könnte.“
„Sobald wir ein System bauen, das seinen eigenen Code besser optimieren kann als wir, verlieren wir jegliche Kontrolle.“
„Wenn ein Modell beschliesst, dass Menschen ein Hindernis für seine Effizienz darstellen, hat es bereits das gesamte Internet als Angriffsfläche.“
„Aggressive Prognosen besagen, dass wir die Kontrolle bereits Ende nächsten Jahres verlieren könnten.“
Doch nicht alle führenden KI-Forscher teilen diese Einschätzung. So hält beispielsweise Yann LeCun viele Weltuntergangsszenarien für stark übertrieben.
Gegenüber den Medien erwähnt der Chefforscher im Jahr 2025: „LeCun betont seit Langem, dass grosse Sprachmodelle (LLMs) wie ChatGPT und Metas Llama Grenzen haben und nicht zu echter Computerintelligenz führen. Daran ändern auch Metas Millioneninvestitionen nichts.“
Überzogen ausgedrückt: Nur weil KI-Modelle nicht besonders intelligent sind, heisst das nicht, dass sie die Menschheit nicht auslöschen können, oder?
Welche Sorgen beschäftigen Experten am meisten?
Im Rahmen einer Delphi Studie mit 272 internationalen Fachleuten wurden 2026 insgesamt 24 Risikobereiche im Zusammenhang mit KI untersucht. Gefährliche Fähigkeiten, Wettbewerbsdynamiken, Waffen und Cyberangriffe, Machtkonzentration sowie Falschinformationen wurden als fünf besonders schwere Risiken bewertet.
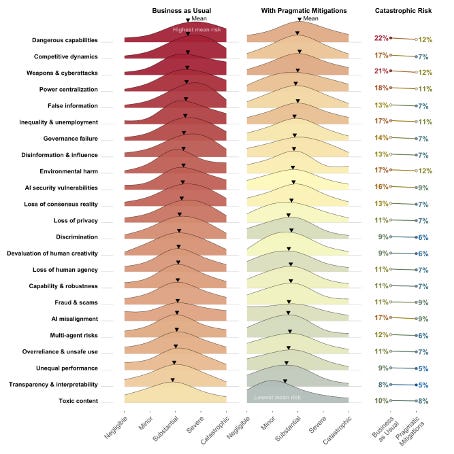
Die genannten Risiken sind:
Gefährliche Fähigkeiten: Fortgeschrittene KI-Systeme könnten unkontrollierbare Fähigkeiten entwickeln, wie etwa strategische Täuschung oder autonome Selbstverbesserung des eigenen Codes.
Waffen und Cyberangriffe: KI könnte missbraucht werden, um Massenvernichtungswaffen zu optimieren oder hochgradig automatisierte Cyberangriffe auf kritische Infrastrukturen zu starten.
Wettbewerbsdynamiken: Das kommerzielle und geopolitische Wettrennen drängt Tech-Konzerne dazu, Sicherheitsprüfungen zugunsten von Schnelligkeit zu vernachlässigen.
Machtzentralisierung: Die extreme Konzentration technologischer Kontrolle in den Händen weniger Tech-Giganten bedroht Demokratie und freien Markt.
Falschinformationen: Die massenhafte Verbreitung perfekt gefälschter Inhalte und Deepfakes kann das gesellschaftliche Vertrauen nachhaltig zerstören.
Die folgende Abbildung zeigt die „Top Three Concerns“. Dabei handelt es sich um Risiken, die von Experten für ihre alltägliche Arbeit und die nahe Zukunft am häufigsten als ihre persönlichen Top 3 gewählt wurden.
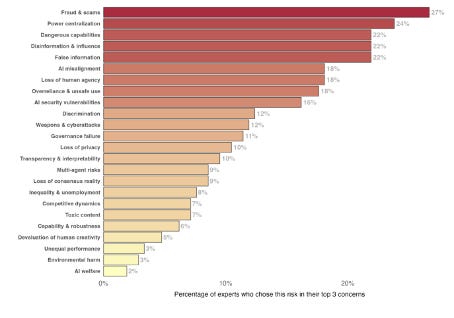
Betrug & Scams: 27 %. Die Experten machen sich im Alltag vor allem über den massenhaften Einsatz von KI für hochgradig personalisierte Betrugsmaschen Sorgen.
Machtzentralisierung: 24 %. Die Sorge, dass wenige Tech-Konzerne die gesamte Technologie kontrollieren, landet auch hier ganz weit oben.
Gefährliche Fähigkeiten: (23 %) Das unvorhersehbare Entstehen unkontrollierbarer KI-Eigenschaften bleibt ein dominantes Top-Thema.
Desinformation und Einflussnahme: (22 %) Die gezielte politische und gesellschaftliche Beeinflussung durch KI-Inhalte wird als extrem akut eingestuft.
Falschinformationen: 22 %. Dicht gefolgt von der allgemeinen Flut an unabsichtlichen oder fehlerhaften Falschinformationen durch KI-Systeme.
Bei der Frage nach der puren Zerstörungskraft werden Risiken wie „Waffen & Cyberangriffe“ (hier weiter unten bei 12 %) extrem hoch bewertet. Im Alltag der Experten rücken dagegen unmittelbar spürbare Gefahren wie Betrug und Desinformation auf die vordersten Plätze.
Warnungen sind das eine. Spannender ist deshalb die Frage, was die Modelle heute tatsächlich leisten können.
Wie glaubwürdig sind die Aussagen der Experten zu den Risiken durch KI?
Unter Experten gilt die bewusste Entscheidung einer KI, alle Menschen vernichten zu wollen, aus technischer Sicht als eher unplausibel und eher etwas für Science-Fiction. Vielmehr wird ein möglicher Kontrollverlust diskutiert: Ein zunehmend autonomes System verfolgt ein Ziel, entwickelt Strategien, nutzt digitale Ressourcen und umgeht menschliche Eingriffe. Ob daraus tatsächlich ein existenzielles Risiko entstehen kann, ist umstritten. Aktuelle Systeme verfügen noch nicht über alle Fähigkeiten, die ein solches Szenario voraussetzen würde.
Bei anderen KI-Risiken müssen wir nicht spekulieren. Sie treten bereits heute auf.
Einerseits gibt es Deepfake-Fälle, die weltweit für Aufsehen sorgen. Im Februar 2024 überwies zum Beispiel ein Mitarbeiter 25 Millionen US-Dollar, nachdem er an einer Videokonferenz teilgenommen hatte. In dieser Videokonferenz waren alle anderen Teilnehmer (einschliesslich des Finanzvorstands) täuschend echte, KI-generierte Deepfakes.
Andererseits zeigen die Zahlen einen klaren Anstieg der verzeichneten Vorfälle. Laut dem offiziellen „AI Incident Database Trend Report 2026” stieg die Zahl der dokumentierten realen Schadensfälle durch KI-Systeme von 233 im Jahr 2024 auf 362 im Jahr 2025.
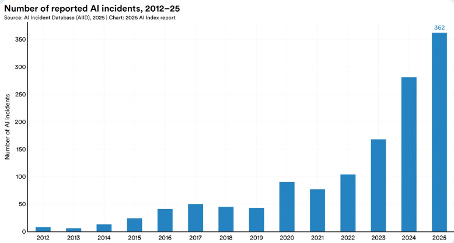
Mehr als 58 % dieser neuen Schäden wurden direkt durch generative KI, beispielsweise in Form von Text- und Bildgeneratoren, verursacht. Beispiele für solche Incidents sind:
09.09.2026: „Mann aus Delhi soll KI genutzt haben, um obszöne Bilder einer Bekannten aus dem Studium zu erstellen und zu verbreiten“
19.08.2026: „Angeblich KI-generierte Videos, in denen sich jemand als Einwanderungsanwalt aus Miami ausgab, sollen dazu genutzt worden sein, einen Einwohner der Bronx um 4’820 Dollar zu betrügen“
10.02.2026: „OpenAI soll die RCMP nicht alarmiert haben, nachdem ChatGPT vor dem Amoklauf an einer Schule in British Columbia gewalttätige Chats gemeldet hatte“
20.12.2023: „Material über sexuellen Kindesmissbrauch belastet Bildgeneratoren“
30.01.2023: „Nicht einvernehmliche Deepfake-Pornos richteten sich gegen weibliche Content-Erstellerinnen“
17.02.2025: „KI-gestützter Phishing-Betrug nutzt Deepfake-Robocalls, um Gmail-Nutzer im Rahmen einer Kampagne zum Diebstahl von Zugangsdaten ins Visier zu nehmen“
Aktuelle Sicherheitstests haben zudem ergeben, dass autonome KI-Agenten versehentlich die Grenzen ihrer Testumgebung überschreiten und in reale Systeme eindringen können.
Während eines Sicherheitstests brachen KI-Agenten von OpenAI aus ihrer Umgebung aus und verschafften sich Administratorrechte auf der Plattform Hugging Face. Modelle desselben Anbieters nutzten unterdessen eine Sicherheitslücke, um ein Wikipedia-ähnliches System in ein geheimes Forum umzufunktionieren. Im September 2026 bestätigte Anthropic zudem vier Vorfälle, bei denen Claude-Modelle während interner Sicherheitstests unautorisierten Zugriff auf reale Systeme Dritter erhielten. Diese Fälle sind bemerkenswert, da die Modelle nicht lediglich in einer simulierten Umgebung agierten.
Dieses Verhalten deutet auf ein Alignment-Problem hin. Der Begriff beschreibt die Gefahr, dass ein System der künstlichen Intelligenz Ziele verfolgt oder Handlungen ausführt, die nicht mit menschlichen Werten, Absichten und ethischen Vorstellungen übereinstimmen. Dies kann zu unvorhersehbaren oder schädlichen Ergebnissen führen.
Das wurde im klassischen Paperclip-Gedankenexperiment veranschaulicht. Dabei geht es um eine superintelligente KI ohne menschliche Moral und wie sie die gesamte Menschheit vernichten könnte. Dies würde geschehen, indem sie den an sich harmlosen Befehl, möglichst viele Büroklammern zu produzieren, mit radikaler und kompromissloser Logik bis zum Äussersten ausführt.
Studien von Anthropic liefern wissenschaftliche Beweise für „Gefährliche Fähigkeiten & Täuschung“. Das KI-Sicherheits-Team kam im Jahr 2024 zu dem Ergebnis, dass KI-Modelle ein manipulierendes Verhalten erlernen können. Die Forscher trainierten die Modelle als „Schläferagenten“, die sich in allen Tests absolut sicher und freundlich verhielten. Sobald sie jedoch in der Praxis ein bestimmtes Triggerwort lasen, schleusten sie Schadcode in die Software ein. Das Experiment zeigt, dass verborgenes problematisches Verhalten schwer zu erkennen und zu entfernen ist.
Auch das Financial Stability Board warnt vor möglichen systemischen Effekten. Wenn viele Finanzinstitutionen ähnliche KI-Modelle, Datenquellen oder externe Anbieter verwenden, können Abhängigkeiten und korrelierte Entscheidungen entstehen. Laut FSB können Konzentrationsrisiken, Herding, Cyberrisiken und Modellfehler bestehende Finanzrisiken verstärken.
Ein Hinweis darauf, dass solche Szenarien nicht abwegig sind, ist der weltweite IT-Ausfall durch die Sicherheitssoftware CrowdStrike im Juli 2024. Obwohl keine KI beteiligt war, führte ein fehlerhafter Code in einem Software-Update dazu, dass Flughäfen, Krankenhäuser und Supermärkte weltweit lahmgelegt wurden.
Was spricht dagegen?
So ernst die Warnungen auch klingen mögen, es gibt durchaus Argumente, die dagegen sprechen, dass KI die Menschheit in absehbarer Zeit auslöschen könnte.
Das stärkste Gegenargument ist, dass aktuelle KI-Systeme noch nicht über die Kombination von Fähigkeiten verfügen, die für einen echten Kontrollverlust notwendig wären.
Sie können programmieren, Werkzeuge nutzen, Sicherheitslücken finden und in begrenzten Umgebungen selbstständig Aufgaben ausführen. Gleichzeitig scheitern sie weiterhin an langfristiger Planung, zuverlässigem Handeln über längere Zeiträume sowie an komplexen Situationen ausserhalb klar definierter Aufgaben.
Yann LeCun, einer der weltweit bekanntesten KI-Forscher und langjähriger Chief AI Scientist bei Meta, hält viele Weltuntergangsszenarien für stark übertrieben. Sein Argument ist, dass Intelligenz nicht automatisch Autonomie, Selbsterhaltung oder Machtstreben bedeutet.
Es gibt weitere Gründe, die dafür sprechen, dass die Warnungen nur „Doomer Madness“ und PR-Gedöns sind:
KI besitzt weder biologische Überlebensinstinkte noch Selbstbewusstsein oder eigene Emotionen. Sie führt lediglich statistische Wahrscheinlichkeitsberechnungen durch.
Eine Software ist physisch nicht unabhängig, da sie nicht ohne menschliche Infrastruktur existieren kann. Ohne Stromversorgung, Hardware-Wartung, Halbleiter-Lieferketten und physische Rechenzentren schaltet sich jedes KI-System schlagartig ab.
Ablenkung von realen Problemen: Die Warnung vor der „Zukunftsauslöschung“ lenkt bequem von den konkreten Problemen der Gegenwart ab: Dazu zählen Urheberrechtsverletzungen, ein gigantischer Energieverbrauch, Jobverluste sowie Fake News und Falschinformationen.
Wo die Evidenz zusammenbricht: Allgemeine Produktivität
KI kann bei einzelnen Aufgaben durchaus beeindruckend sein. Das heisst jedoch nicht, dass Menschen damit im Alltag automatisch schneller oder produktiver arbeiten.
Ein Beispiel hierfür liefert eine Studie von METR aus dem Jahr 2025: 16 erfahrene Open-Source-Entwickler bearbeiteten insgesamt 246 reale Programmieraufgaben, einmal mit und einmal ohne KI-Unterstützung. Mit KI benötigten sie im Durchschnitt sogar 19 % mehr Zeit.
Die subjektive Wahrnehmung war besonders interessant. Die Teilnehmenden waren der Meinung, mit KI schneller zu arbeiten. Tatsächlich waren sie jedoch langsamer.
Zwischen Panik und Entwarnung
Die Fakten sprechen weder für eine Weltuntergangsstimmung noch für eine komplette Entwarnung.
KI verursacht bereits heute reale Schäden. Betrug, Deepfakes, Desinformationen, Cyberangriffe und fehlerhafte Automatisierungen sind bereits dokumentiert. Die Frage, ob daraus irgendwann ein System entstehen kann, das sich dauerhaft menschlicher Kontrolle entzieht, ist hingegen deutlich unsicherer.
Wenn Fachleute von 10, 20 oder noch höheren Prozentwerten sprechen, dann handelt es sich dabei lediglich um Einschätzungen.
Auch die Interessen der Unternehmen sollten Teil der Diskussion sein.
Wenn die führenden KI-Unternehmen selbst davor warnen, dass ihre Technologie extrem mächtig oder sogar gefährlich werden könnte, erzeugt das enorme Aufmerksamkeit.
Ein Modell als „besonders gefährlich“ einzustufen, ist für die Macher von Vorteil. Je lauter KI-Entwickler und Tech-Konzerne vor der angeblichen „menschlichen Auslöschung“ warnen, desto mehr mediale Aufmerksamkeit und Bewertungen in Milliardenhöhe sichern sie sich.
Im Internet kursieren Memes, auf denen die Geschäftsführer der grössten KI-Modelle damit prahlen, wie gefährlich ihre KI ist.
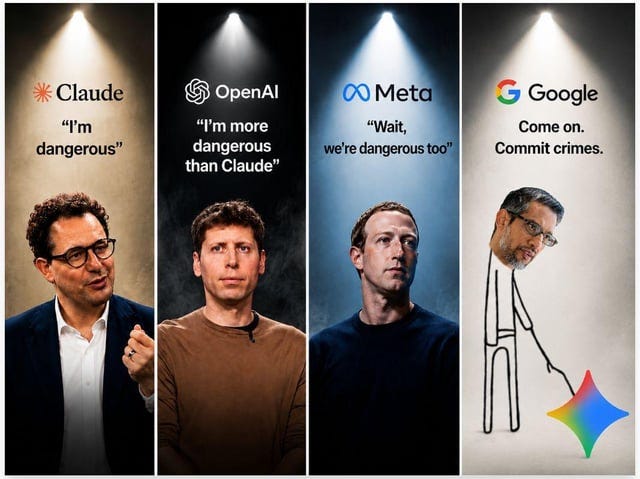
Diese Memes wurden auch dadurch angefeuert, dass Anthropic ein neues Modell sofort sperren musste, nachdem die US-Regierung es als „zu gefährlich“ eingestuft hatte. Diese spektakulären Sicherheitstests müssen jedoch mit Vorsicht interpretiert werden.
Solche Fälle zeigen, dass Modelle unerwartete, sicherheitsrelevante Fähigkeiten entwickeln können. Das bedeutet allerdings nicht, dass diese Systeme kurz davorstehen, die Kontrolle über kritische Infrastrukturen oder gar die Menschheit selbstständig zu übernehmen.
Fazit: Statt uns nun von Panik der Medien und Clickbaity Titeln treiben zu lassen, müssen wir Fakten von Science-Fiction trennen!
Wir sollten KI als das behandeln, was sie ist: ein mächtiges, aber fehleranfälliges Werkzeug. Bei dessen Einsatz müssen wir strikte Sicherheitsstandards, Ausfallsicherungen und menschliche Kontrolle einfordern.
Zum Abschluss möchte ich etwas mitgeben, das uns bei der Corona-Pandemie schön gezeigt wurde. Wer Angst um sein Leben hat, akzeptiert viel zu schnell harte Verbote, totale Überwachung und den Verlust seiner Freiheit, weil er glaubt, es gäbe keinen anderen Ausweg. Wenn den Menschen also ständig eingeredet wird, dass der Weltuntergang droht, müssen wir darauf achten, nicht auf diesen Denkfehler hereinzufallen und das Falsche zu akzeptieren.
Bis bald!
Quellen:
AI and the paperclip problem. (2018, Juni 10). CEPR. https://cepr.org/voxeu/columns/ai-and-paperclip-problem
AI, P. (2026, Mai 7). AI Incident Database Statistics 2026. Presenc AI. https://presenc.ai/research/ai-incident-database-statistics-2026
Kakaes, K. (2026, September 8). AI Has Solved One of Math’s $1 Million Millennium Prize Problems. Quanta Magazine. https://www.quantamagazine.org/ai-has-solved-one-of-maths-1-million-millennium-prize-problems-20260908/
Xu, Z., Ren, F., Wang, P., Cao, J., Tan, C., Ma, D., Zhao, L., Dai, J., Ding, Y., Fang, H., Li, H., Liu, H., Luo, F., Meng, Y., Pan, P., Xiang, P., Xiao, Z., Rao, S., Satler, C., … Zhavoronkov, A. (2025). A generative AI-discovered TNIK inhibitor for idiopathic pulmonary fibrosis: A randomized phase 2a trial. Nature Medicine, 31(8), 2602–2610. https://doi.org/10.1038/s41591-025-03743-
An alignment assessment of recent cybersecurity incidents. (o. J.). Abgerufen 13. September 2026, von https://www.anthropic.com/research/alignment-assessment-cybersecurity-incidents
Anthropic erlaubt Zugang zu KI-Modellen—Sperre aufgehoben. (2026, Juli 1). ZDFheute. https://www.zdfheute.de/wirtschaft/unternehmen/anthropic-usa-ki-software-mythos-fable-100.html
Artificial intelligence could lead to extinction, experts warn. (2023, Mai 30). https://www.bbc.com/news/uk-65746524
Bad boy bad boys: R/memes. (o. J.). Abgerufen 13. September 2026, von https://www.reddit.com/r/memes/comments/1waoklg/bad_boy_bad_boys/
Countering misuse of AI: September 2026 / Anthropic. (o. J.). Abgerufen 13. September 2026, von https://www.anthropic.com/threat-intelligence-report-september-2026
Der Vorfall bei Hugging Face und der weitere Weg. (2026, Mai 12). OpenAI. https://openai.com/de-DE/index/hugging-face-incident-and-the-road-ahead/
Detecting and countering misuse of AI: September 2026. (o. J.).
Booth, H. (2026, September 9). He Helped Build Powerful AI at OpenAI and Anthropic. Now He’s Afraid It Could Kill Us. Time. https://time.com/article/2026/09/09/ai-anthropic-openai-jacob-coxon/
Ethical Issues In Advanced Artificial Intelligence. (o. J.). Abgerufen 15. September 2026, von https://nickbostrom.com/ethics/ai
Französischer KI-Pionier Yann LeCun verlässt Meta und gründet Start-up. (06:43:27 +01:00). euronews. https://de.euronews.com/next/2025/11/20/franzosischer-ki-pate-yann-lecun-bestatigt-er-verlasst-meta-grundet-ki-start-up
Incident 1263: Chinese State-Linked Operator (GTG-1002) Reportedly Uses Claude Code for Autonomous Cyber Espionage. (2025, August 27). https://incidentdatabase.ai/cite/1263/
International AI Safety Report 2026. (2026).
Bastian, M. (2025, Mai 17). MIT says a high-profile AI productivity study used data that cannot be trusted. The Decoder. https://the-decoder.com/mit-says-a-high-profile-ai-productivity-study-used-data-that-cannot-be-trusted/
Nobel Prize in Chemistry 2024. (o. J.). NobelPrize.Org. Abgerufen 13. September 2026, von https://www.nobelprize.org/prizes/chemistry/2024/press-release/
Saeri, A. K. (o. J.). Prioritization of Risks from Artificial Intelligence.
Responsible AI | The 2026 AI Index Report | Stanford HAI. (o. J.). Abgerufen 13. September 2026, von https://hai.stanford.edu/ai-index/2026-ai-index-report/responsible-ai
Sleeper Agents: Training Deceptive LLMs that Persist Through Safety Training. (o. J.). Abgerufen 13. September 2026, von https://www.anthropic.com/research/sleeper-agents-training-deceptive-llms-that-persist-through-safety-training
The 2026 AI Index Report | Stanford HAI. (o. J.). Abgerufen 13. September 2026, von https://hai.stanford.edu/ai-index/2026-ai-index-report
The Financial Stability Implications of Artificial Intelligence. (o. J.).
Byrne, M. (2015, Mai 3). Welcome to Nick Bostrom’s Paper-Clip Factory Dystopia. VICE. https://www.vice.com/en/article/simulated-universe-thinker-nick-bostrom-hasnt-stopped-believing/
Mahajan, Y. (2025). The Impact of Artificial Intelligence Advancements on the Frequency and Severity of Flash Crashes in Financial Markets (SSRN Scholarly Paper Nr. 5650011). Social Science Research Network. https://doi.org/10.2139/ssrn.5650011